


cfRNA定量的“半程陷阱”?Smile cfRNA-seq:一次检测10类分子,揭秘真绝对定量真相
传统 cfRNA 测序的三大隐形陷阱
❌️ "仅 UMI 去 PCR 重复" ≠ 绝对定量:无法校正 RNA 提取损失、逆转录效率差异,跨样本数据不可比
❌️相对定量误导筛选:比例变化 ≠ 真实分子数变化,假阳性率高,潜在 Biomarker 漏检
❌️ 低丰度分子"看不见":微量 cfRNA 丢失,关键生物标志物潜藏其中
cfRNA:液体活检领域极具转化潜力的分子标志物
液体活检赛道持续升温,凭借无创取样、可重复监测、能全景反映全身组织状态的核心优势,早已从肿瘤诊断领域延伸至全疾病周期的临床研究与应用探索。当 cfDNA(cell-free DNA) 的临床价值逐步落地,承载着更丰富转录调控信息的 cfRNA(cell-free RNA),正凭借其独有的动态表达特征,成为疾病生物标志物挖掘的全新蓝海。体液中游离RNA分子种类繁多,涵盖mRNA、lncRNA、miRNA、piRNA、tsRNA等多种类型,每一类都携带不同层次的调控信号。从肿瘤早筛到移植监测,从妊娠评估到神经疾病研究,游离 RNA 凭借无创取样、实时动态、多组织溯源的独特优势,具备极高的科研价值与临床转化应用前景。
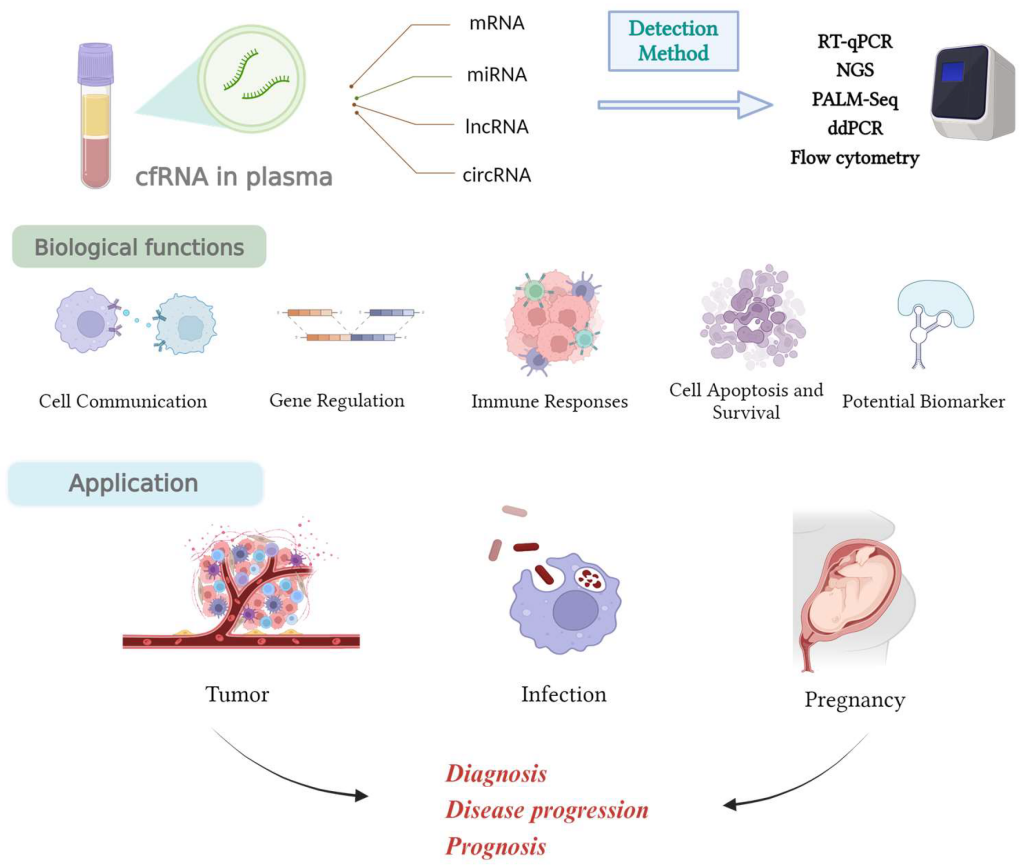
An overview of cfRNA in plasma
然而,要将cfRNA这份巨大的转化潜力转化为真实可靠的科研成果,必须跨越一道基础但关键的障碍——定量的准确性与可比性。传统cfRNA研究长期面临两大瓶颈:其一,定量方法不统一——多数方案仅依赖相对定量指标(如FPKM、TPM),跨样本、跨批次数据难以直接比较,大量潜在biomarker在验证阶段即因数据不可比而折戟;其二,分子覆盖不全面——长链RNA与短链RNA需分库检测,不仅消耗珍贵的体液样本,更人为割裂了不同类型cfRNA分子间的天然关联,使研究者难以获得转录组全貌。
为了系统性解决这两大痛点,云序生物推出Smile cfRNA-seq真·绝对定量测序。以下,我们将从两个维度展开:第一,什么是真正的“绝对定量”——为何仅靠UMI只能算半程校正?第二,一次检测覆盖10类cfRNA分子——如何在同一份样本中捕获转录组全景?
警惕"伪绝对定量":仅靠UMI,远非真正的全流程校正
当前行业内,不少产品仅仅通过在接头中引入UMI(Unique Molecular Identifier,唯一分子标识符)序列,便高调宣称实现了"绝对定量"。从宣传话术看,UMI确实能标记原始分子,在建库扩增后归并PCR重复读数,消除扩增偏好——但这一技术的校正范围,仅仅局限于"逆转录完成之后"的扩增与测序环节。
对于RNA提取环节的物理损失、不同样本间逆转录效率的天然差异、以及手动操作中不可避免的系统偏差,UMI完全束手无策。更值得深思的是,UMI作为接头连接序列,本身并无技术壁垒——所有接头生产厂商均可合成带有随机UMI序列的通用接头。仅凭这一通用配件就标榜"绝对定量",本质上是将"半程校正"偷换为"全流程定量",输出的数据依然带有强烈的批次效应,难以支撑大样本分子标志物研究的需求。这种"伪绝对定量"不仅浪费珍贵的临床样本,更可能误导后续验证方向,让研究者误判候选分子的真实价值。
三重协同破局,告别"半程校正"的伪绝对定量
针对上述痛点,云序生物全新推出Smile cfRNA 真・绝对定量测序,真正做到了全流程定量校正,通过Spike-in + UMI + UDI 三重技术联动,覆盖 "提取 - 逆转录 - 建库 - 测序" 全实验环节,从不同维度系统性消除实验各阶段的偏差与干扰:
Spike-in(外源仿生内标)采用与人类基因组无同源性、长度匹配 cfRNA 片段特征的人工合成 RNA 标准品,在逆转录反应开始前以已知精准浓度加入每份样本。其核心原理是以内标分子的理论投入量为参照,通过测序后检测到的内标实际回收率,反向定量推算样本在 RNA 纯化、片段富集、逆转录等上游环节中的分子损失与酶促反应效率波动,进而对所有内源 cfRNA 的定量结果进行归一化校正,从根源上拉平不同样本、不同批次间前处理操作带来的系统偏差,确保所有定量数据统一于同一量化基准。
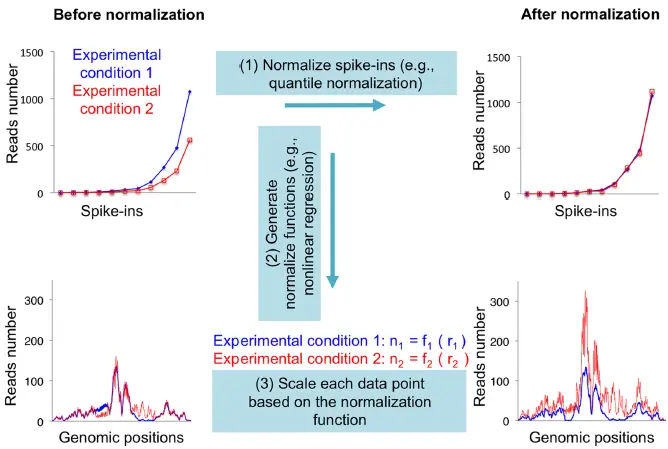
Spike-in Normalization
UMI(唯一分子标识符,Unique Molecular Identifier)则针对扩增环节偏差进行精准校正:在 PCR 扩增起始前,为体系中每一个原始 cDNA 分子末端连接一段随机序列构成的专属分子标签。后续所有经 PCR 扩增产生的同源拷贝均会携带相同的 UMI 序列,测序完成后通过生物信息学算法对 UMI 序列进行聚类归并,将共享同一标签的所有读段计数为单个原始分子。该方法可彻底消除 PCR 扩增偏好性、测序平台重复读取带来的定量冗余,真正实现 "一个原始分子仅计数一次",精准还原样本中 cfRNA 的原始分子丰度。
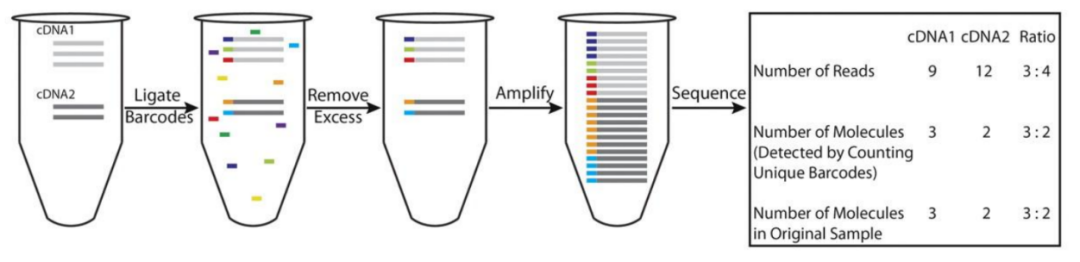
UMI消除PCR偏好性定量转录组
UDI(双端唯一索引,Unique Dual Index)聚焦多样本混样测序的准确性:文库构建过程中,为每一份样本的 cDNA 分子两端同时接入唯一的索引条码序列。在多样本混合上机测序后的数据拆分环节,通过双端索引的双重校验机制,可显著降低单索引模式下易出现的标签跳跃与样本串扰,保障每条测序读段都能精准追溯至其原始样本,有效避免样本间交叉污染对定量准确性的干扰。
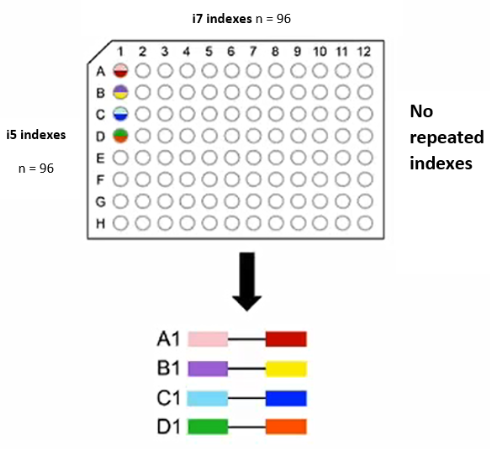
双端唯一索引(每个96孔板含有96个独特的i5和96个独特的i7)
三者协同作用,从上游前处理、中间扩增到末端测序全链条校正误差,彻底解决传统相对定量方法的固有偏差,让 cfRNA 定量结果具备真正的跨样本、跨批次可比性。
真 vs 伪绝对定量对比
|
对比维度 |
市面"伪"绝对定量 |
云序Smile 真·绝对定量 |
|
技术核心 |
仅UMI 去 PCR 重复 |
Spike-in + UMI + UDI 三重协同 |
|
校正提取损失 |
✖ 不能 |
✔ Spike-in 全程监控 |
|
校正逆转录效率 |
✖ 不能 |
✔ 内标实时校正 |
|
跨样本/批次可比性 |
✖ 相对比例,难对齐 |
✔ 原始拷贝数,可直接合并 |
|
适合用途 |
初筛、探索性研究 |
Biomarker 筛选、临床转化、多中心研究 |
云序Smile cfRNA-seq:真·绝对定量分子标志物研究利器
云序生物Smile cfRNA-seq,专为 Biomarker 筛选深度定制,以 S-M-I-L-E(Spike-in, Molecular ID, Indexing for Level Evaluation)五重技术架构重新定义 cfRNA 定量金标准,单文库实现 10 类 cfRNA 分子同步精准检测,全流程校正实验误差,为疾病标志物研究与临床转化提供坚实的数据支撑。
SMILE(Spike-in, Molecular ID, Indexing for Level Evaluation)cfRNA-seq
|
字母 |
名称 |
技术说明 |
用户收益 |
|
S |
Spike-in仿生内标 |
专为cfRNA 长度定制的非亲缘标准品,逆转录前加入每份样品 |
随行标尺,全程校正提取与酶促损失,跨样本站在同一基准线 |
|
M |
Molecular IDs UMI分子标签 |
cDNA 扩增前为每分子连接独有标签,测序后归并重复读数 |
每个原始分子只算一次,彻底消除PCR 扩增冗余 |
|
I |
Indexing UDI双端索引 |
双端唯一索引,多样本混样测序零串扰 |
每条read 精准追溯至原始样本,数据归属零误差 |
|
L |
Level Evaluation绝对丰度输出 |
输出每份样品各类cfRNA 的原始拷贝数 |
直接获得绝对分子数,而非相对比例,差异分析更可靠 |
|
E |
Empowering Biomarker Discovery |
S-M-I-L-E 全流程协同,生成绝对拷贝数矩阵 |
为疾病标志物筛选与转化研究提供坚实数据底座 |
单文库全覆盖,一次检测10类cfRNA分子
在Biomarker筛选中,广度决定发现的可能性,精度保证发现的可靠性。Smile cfRNA-seq采用单文库全转录组兼容建库策略,通过优化接头连接体系与逆转录反应条件,在同一反应体系中同时捕获长链(>200 nt)与短链(≤200 nt)RNA分子。
一次测序即可同步精准定量mRNA、lncRNA、miRNA、piRNA、tsRNA、yRNA、snRNA、snoRNA、rsRNA、srp_RNA共10类cfRNA分子。建库过程中,引入 UDI(双端唯一索引)接头确保样本间数据互不串扰;同时为每个原始 RNA 分子添加 UMI(分子条形码)用于 PCR 扩增偏好的精确校正;并加入已知浓度的 Spike-in 作为外部参照,用于构建绝对定量标准曲线。通过高通量测序平台进行深度测序,确保低丰度分子的有效检出。无需拆分样本、无需多次实验,全面捕获cfRNA转录组全貌,最大限度保留样本信息完整性,为Biomarker筛选提供更广谱、更高效的检测视野。
多场景适配,解锁cfRNA研究多元价值
cfRNA 作为"液体活检"的重要组成部分,不同类型cfRNA在体液中各自承载独特的生物学信号——从基因表达水平、转录调控状态到细胞间通讯网络——共同构成一张覆盖肿瘤、生殖、免疫、感染、慢病等主流研究方向,并不断向更多疾病谱系延伸的全景式分子探测网络。
-
cfRNA分子临床应用场景
|
应用领域 |
核心价值 |
典型cfRNA 类型 |
|
癌症早筛与诊断 |
溯源肿瘤组织、发现早期信号、监测治疗响应 |
miRNA、lncRNA、mRNA、piRNA、srpRNA、snoRNA |
|
产前检测 |
无创获取胎儿遗传信息,评估发育与并发症风险 |
胎儿特异性cfRNA |
|
移植监测 |
早于生化指标发现排斥反应,灵敏度更高 |
供体来源cfRNA |
|
传染病诊断 |
检测病原特异性RNA,监测病毒载量与活动性 |
病原cfRNA、宿主响应 miRNA、tsRNA、yRNA |
|
心血管/神经疾病 |
捕捉组织损伤与应激信号,助力机制研究 |
mRNA、tsRNA、miRNA、snoRNA、rsRNA |
-
cfRNA功能与生物学意义
cfRNA的临床价值在于其在扮演的三类核心生物学角色:
一、细胞间远程通讯
外泌体等胞外囊泡包裹的mRNA、miRNA、lncRNA、piRNA等cfRNA分子,经体液循环被远端靶细胞摄取后,可精准调控靶细胞的增殖、凋亡、代谢等生物学行为,是人体远距离细胞信息传递的核心介质。这一功能为揭示疾病状态下异常细胞通讯网络、发现新型干预靶点提供了重要线索。
二、基因表达精准调控
miRNA、tsRNA、piRNA等小分子非编码RNA被靶细胞摄取后,可持续发挥基因沉默与转录调控等功能,深刻影响机体的生理稳态与病理进程。解析这些分子在疾病中的异常调控机制,为RNA药物靶点开发与精准治疗策略提供了重要基础。
三、活体分子动态足迹
全部10类cfRNA分子的组合谱共同构成了体液中的“转录组全景图”。机体生理代谢与病理损伤均会实时改变cfRNA的组成与丰度,使其成为组织细胞活动的实时“分子快照”。这一特性支撑着疾病早期预警、动态监测、机制溯源与疗效评估的一体化临床应用,是cfRNA作为新型液体活检标志物的核心价值所在。
cfDNA提供的是基因组层面的静态信息,而cfRNA反映的是基因表达的动态状态。多类cfRNA分子协同承载的转录组信息,使研究者能够在同一份样本中同时获取组织损伤信号、基因调控网络动态与细胞间通讯状态等多维度生物学信息——这是cfRNA在生物标志物挖掘与精准医学研究中具备独特价值的核心原因。
高分文献佐证:cfRNA-seq可高效挖掘癌症特异性无创标志物
2021年4月,Nature Communications(IF=14.7)发表了一项cfRNA领域里的研究。该研究依托CCGA大型临床队列,系统优化了cfRNA"样本保存—提取—建库—测序"全流程实验方案,并建立了非癌人群cfRNA基线表达谱,为cfRNA在癌症早筛与组织溯源中的应用提供了权威科研佐证。
期刊:Nature Communications
发表日期:2021年4月
影响因子:14.7
样本类型:血液样本
样本数量:165
测序类型:cfRNA-seq
在方法学层面,研究采用了双重定量质控策略:建库过程中引入ERCC(External RNA Controls Consortium)外源RNA spike-in,全程监控逆转录与建库环节的转化效率,为样本间操作偏差提供校正标尺;数据分析阶段则通过UMI(唯一分子标识符)归并计数,消除PCR扩增偏好与测序重复冗余,实现单分子水平的精准定量。
研究发现,人血浆cfRNA虽以rRNA为主(>95%),但少量mRNA承载了极高的疾病研究价值;与cfDNA相比,cfRNA在功能基因外显子区域覆盖度更高,可精准反映组织特异性表达特征。值得注意的是,非癌血浆中高达68%的基因完全未被检测到——研究将这些区域定义为 "暗通道"(dark channels) ,这些天然低背景区域正是寻找高特异性癌症标志物的理想"矿区"。
正是在这些"暗通道"中,研究成功鉴定出肺癌专属标志物12个、乳腺癌专属标志物8个,其中50%为相应组织特异性基因,且约30%具有癌症亚型区分能力——表明cfRNA不仅能够回答"有没有癌",还能回答"是什么癌"和"是哪一种亚型"。在独立验证队列中,15个标志物得到成功验证,确认了cfRNA biomarker的临床检测潜力。
该研究同时指出,过往cfRNA研究多局限于单一miRNA或少数已知癌基因mRNA,存在机制解释困难、批次效应显著、临床转化率低等系统性缺陷。全转录组cfRNA测序有效突破了传统单分子检测的局限性,为癌症特异性无创标志物挖掘与临床转化搭建了成熟可靠的技术框架——这与Smile cfRNA-seq全转录组无偏检测+真绝对定量(Spike-in全程校正+UMI分子归并+UDI双端索引)的设计理念高度一致,进一步印证了全维度、高精度cfRNA测序在液体活检领域的广阔前景。
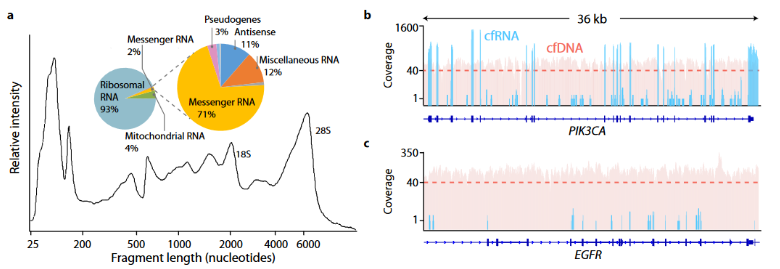
cfRNA全转录组的表征
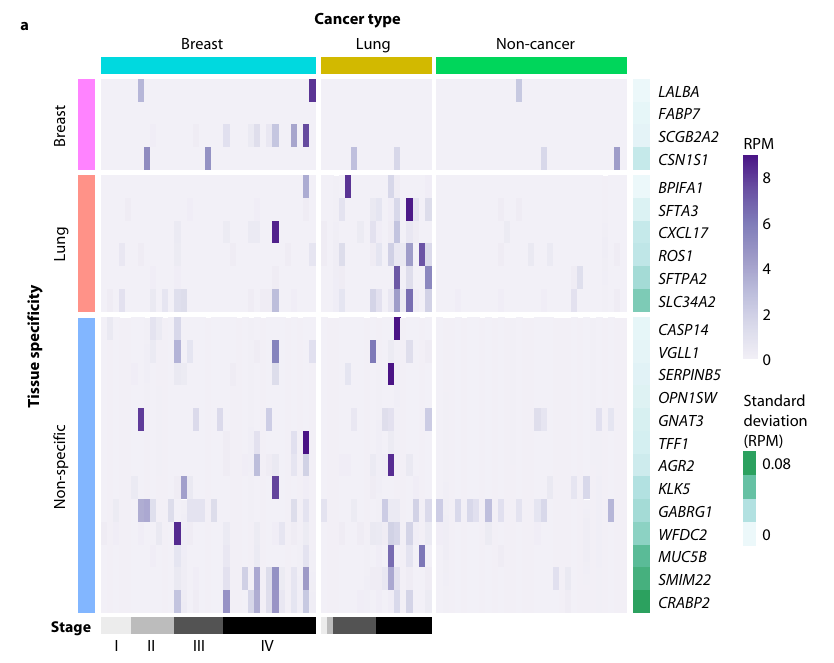
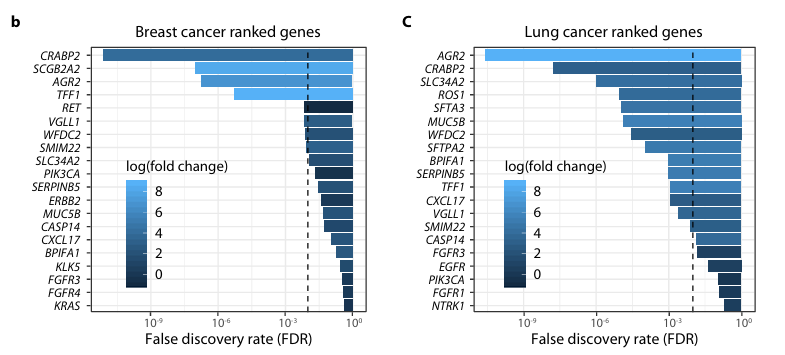
23个DCB基因中的15个在癌症个体中的诊断潜力
如您对相关技术及应用感兴趣,欢迎进一步交流咨询,共同探索这一充满潜力的科学前沿。如果您在研究中遇到任何疑问,可以通过以下方式联系我们:
1.扫码添加小助手【shanghaiyunxu】,一对一咨询;
2.电话咨询:021-64878766,专业团队实时接听,为您解答疑问;
3.访问官网:https://www.cloud-seq.com.cn/,了解更多高通量组学服务详情。
4.邮箱留言:market@cloud-seq.com.cn
我们期待为您服务!
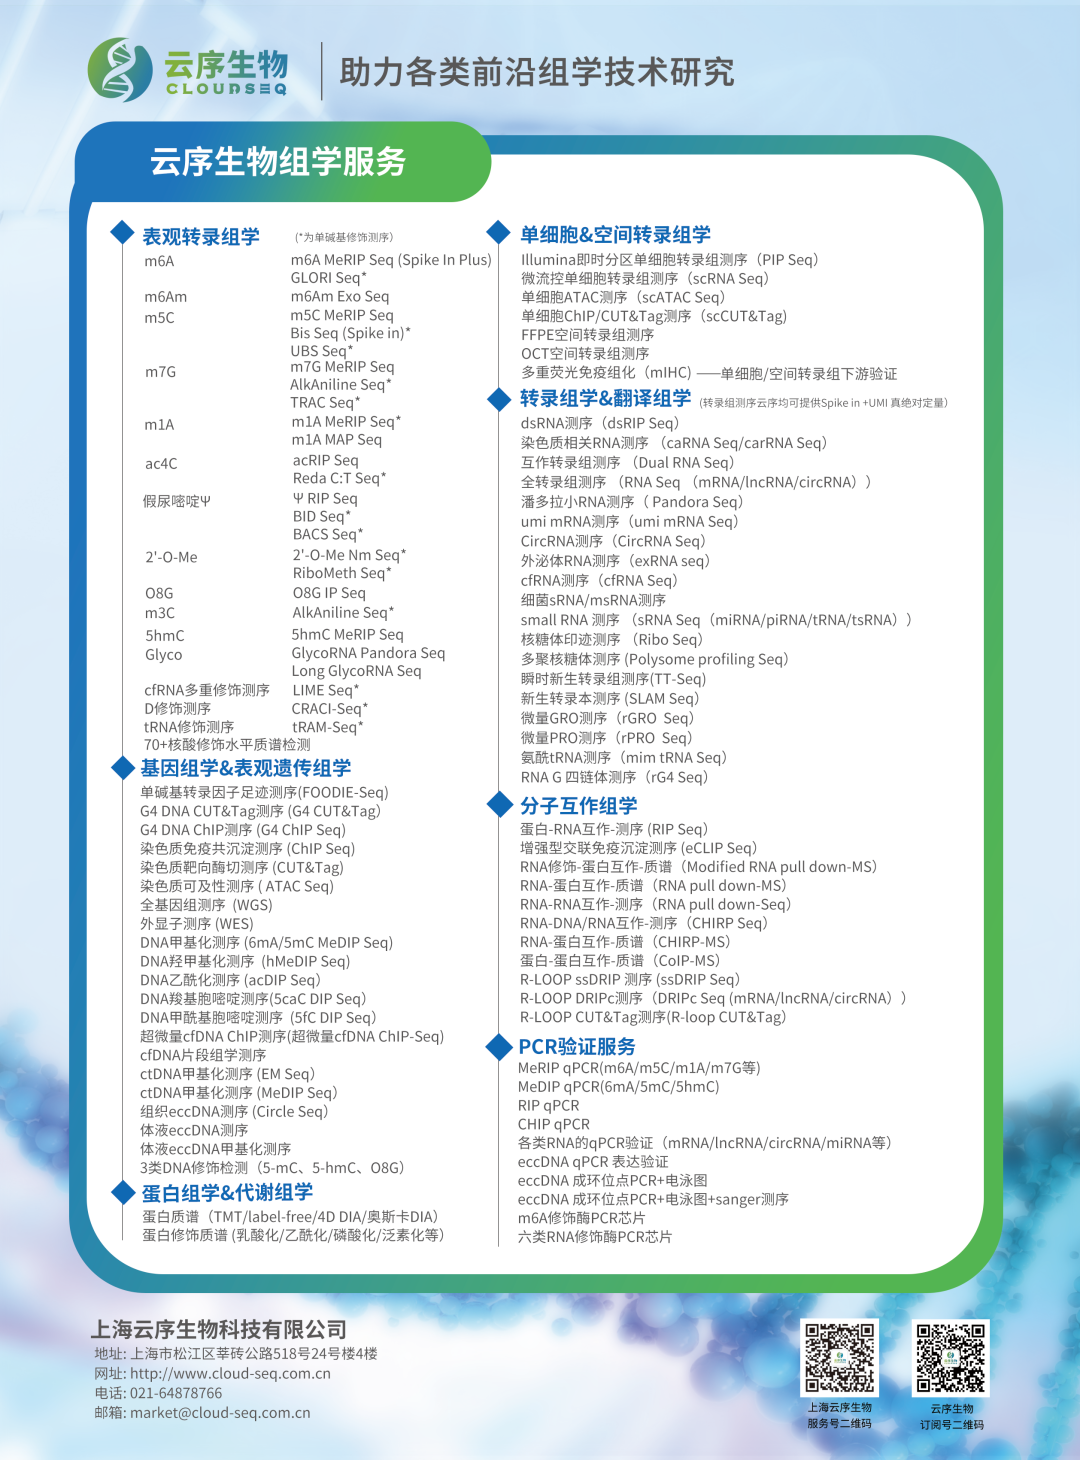
| RNA修饰组 | |
|
|
抗体富集/生物素标记法 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| DNA修饰组 | |
|
|
|
|
|
|
|
|
|
| 表观基因组 | |
|
|
|
|
|
|
|
|
|
|
转录调控组和翻译组 |
|
|
|
|
|
|
|
|
|
|
| 分子互作组 | |
|
|
|
|
|
|
|
|
|
| 转录组 | |
|
|
|
|
|
|
|
|
|
dsRNA(dsRIP-Seq) |
|
| 单细胞测序与空间转录组学 | |
| 单细胞转录组测序 | |
|
|
|
|
|
|
|
|
|
| 基因组 | |
|
|
|
|
|
|
|
|
|
|
蛋白组 |
|
| 定量PCR服务 | |
|
|
|
云序生物介绍
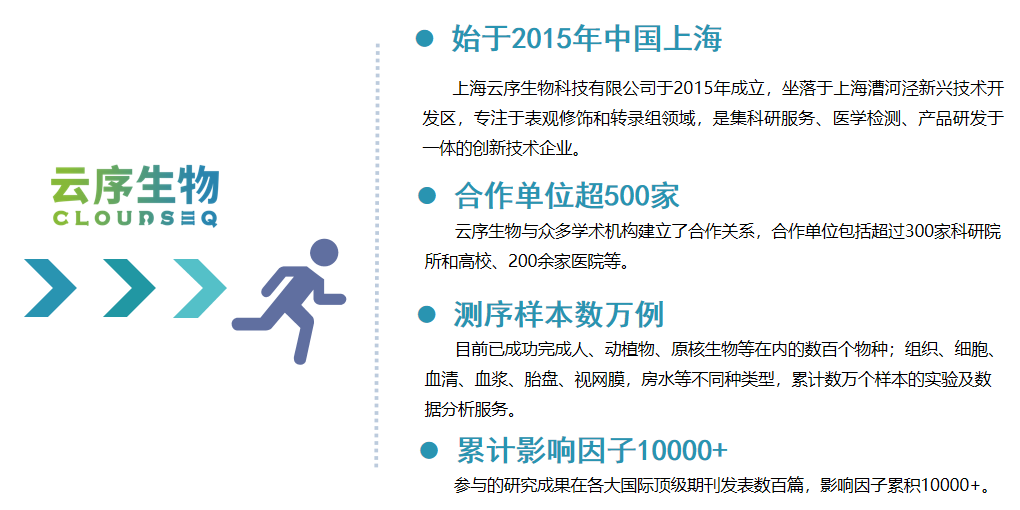
上海云序生物科技有限公司(简称“云序生物”)成立于2015年,坐落于上海漕河泾新兴技术开发区,是国家高新技术企业及ISO9001认证单位。公司以RNA修饰组、表观遗传学与新型时空组学为特色,依托高通量测序、质谱技术、生物信息学等平台,致力于为全球科研与临床用户提供专业、精准、系统性的组学解决方案。云序生物以“技术创新+全链条服务”为核心,通过北大授权的Glori技术应用、临床微量样本技术优化及单细胞-空间多组学整合能力,持续推动表观遗传与转录组学发展,赋能基础科研与精准医疗。
核心优势与创新技术
一、北大授权的Glori技术与特色平台
1. RNA修饰测序技术
北大授权的Glori技术:获北京大学《Nature Biotechnology》发表的单碱基分辨率m6A测序金标准方法授权,实现RNA甲基化图谱的精准解析。
全面单碱基修饰检测:提供m6A、ac4C、m5C、m7G、m1A、O8G等全类别RNA修饰单碱基测序服务,覆盖修饰研究全维度需求。
2. 环状DNA研究全链条服务
核心资源:独家代理国际知名品牌A&A Bio的环状DNA富集纯化柱,实现环状DNA的高效富集,为环状DNA测序保驾护航。
系统性服务:全面提供Circle-Seq、体液eccDNA测序、体液eccDNA甲基化测序等特色服务。
3. 临床微量样本解决方案
针对血浆、FFPE、微量细胞等珍贵样本,推出高灵敏度表观组与转录组技术,如cfMeDIP-Seq,cfDNA EM-Seq,超微量MeRIP-Seq,绝对定量cfRNA测序等。
4. 表观遗传组综合研究平台
覆盖DNA/RNA互作、染色质开放性、组蛋白修饰全维度,如:
R-loop研究(ssDRIP-Seq、DRIPc-Seq、R-loop CUT&Tag)
蛋白-RNA互作(RIP-Seq、RNA Pull-down-MS)
染色质可及性(ATAC-Seq)
组蛋白修饰 (CUT&Tag、ChIP-Seq)
DNA修饰(MeDIP-Seq、hMeDIP-Seq和EM-Seq)
5. 前沿时空组学技术
提供各类前沿单细胞多组学与空间原位分析技术,如单细胞转录组测序、单细胞ATAC测序、单细胞ChIP/CUT&Tag测序、空间转录组以及下游验证服务多重免疫组化(mIHC)等。
上海云序生物科技有限公司
电话:021-64878766
邮箱:market@cloud-seq.com.cn
Shanghai Cloud-seq Biotech Co.,Ltd.
地址:上海松江莘砖公路518号24号楼4楼
